פי 1,000 הוא יחס של GPU-hours, לא קסם של שעון
במאמר SuperMimic המחברים משווים אימון של כ־3 שעות על H100 יחיד ל־7 ימים על 128 כרטיסי L40 בגרסת SONIC שפורסמה. לכן היחס מתייחס למשאבי GPU מצטברים ולמסלול האימון, לא לכך שכל רובוט לומד את אותה יכולת בתוך שלוש שעות. גם סוג הכרטיס, תת־קבוצת הנתונים וההגדרות שונים; בדף הפרויקט המחברים מציינים את ההבדלים האלה וטוענים שהם אינם מסבירים לבדם את כל הפער.
מה נמדד בפועל
הניסוי מדווח על מעקב אחר 129,514 תנועות מתוך סט האימון: 25 כישלונות ל־SuperMimic לעומת 179 ל־SONIC, לפי המאמר. עם שני H100 למשך 9.8 שעות המחברים מדווחים על אפס כישלונות במדד הזה, ומציגים העברה פיזית ל־Unitree G1. זה מדד של כיסוי תנועות שנראו באימון — לא מבחן של תנועות חדשות, מגוון סביבות או עמידות לאורך זמן.
למה מודל עולם דיפרנציאלי משנה את החשבון
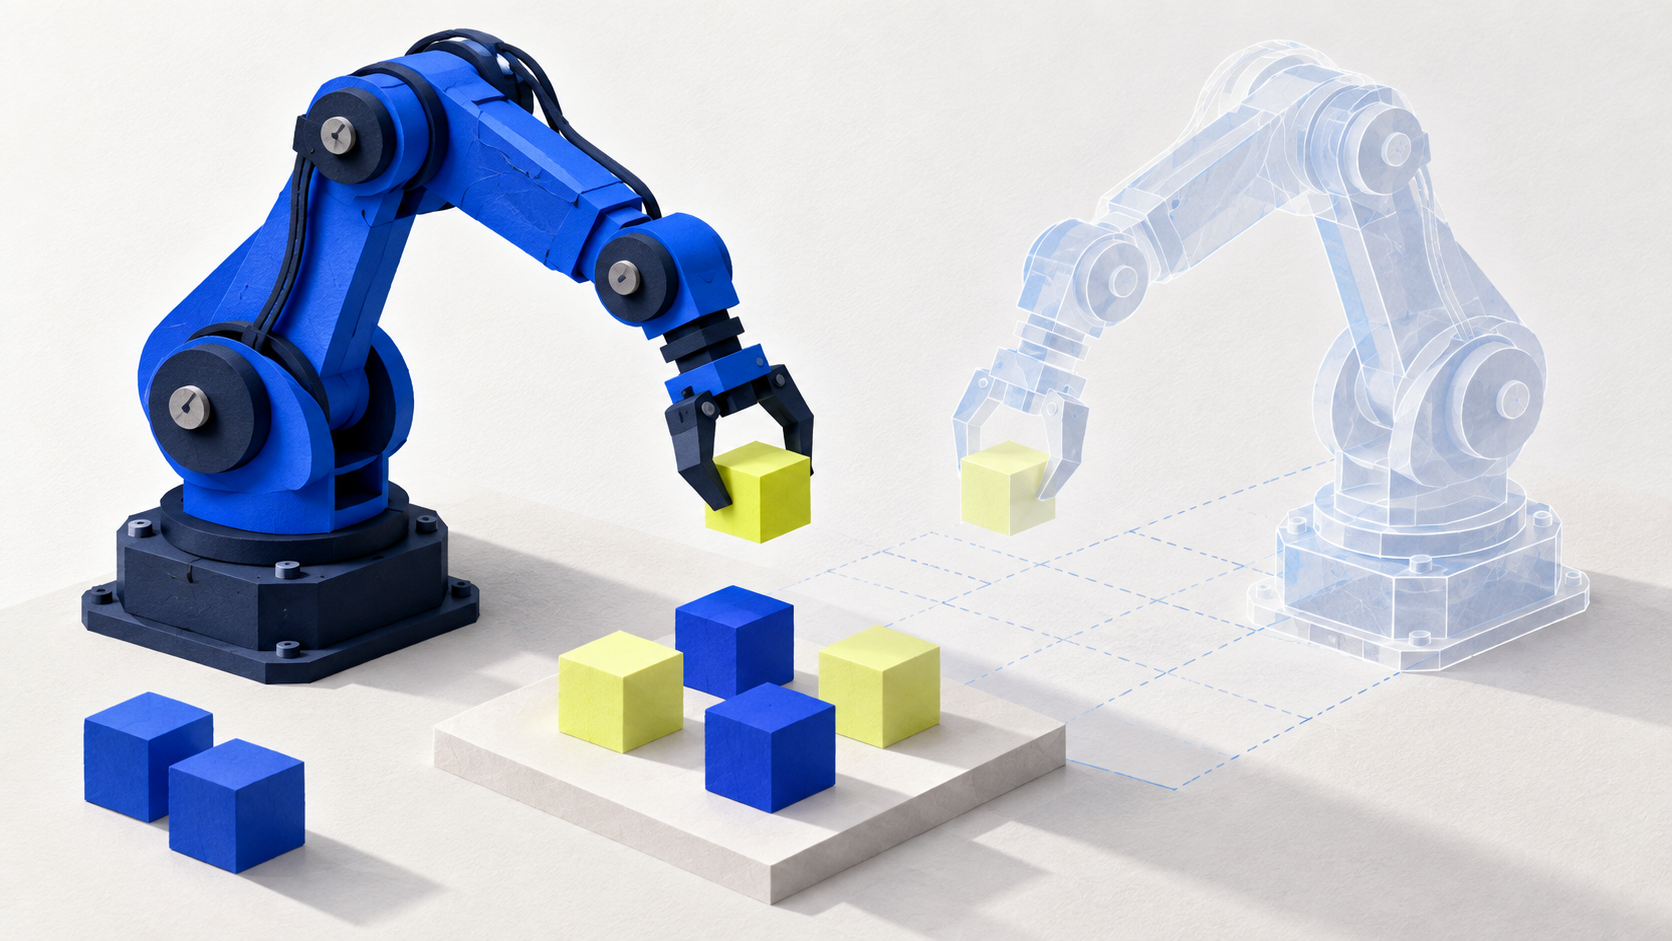
הכיוון של SuperMimic משתמש במודל עולם נלמד ודיפרנציאלי, שמתאים את עצמו ממעברים שהופקו בסימולטור. הגרדיאנטים אינם עוברים דרך הסימולטור עצמו אלא דרך המודל הנלמד, וכך אפשר לשפר את מדיניות השליטה ישירות ולקבל אות למידה רציף יותר. ההסבר מתאר את מנגנון החיסכון כפי שמציגים אותו המחברים; הוא אינו שקול לביקורת חיצונית או לשחזור בלתי תלוי של כל התוצאות.
מה עדיין לא הוכח
הפער אינו הוכחה שכל משימת הליכה או מניפולציה תתאמן פי 1,000 מהר יותר. צריך להפריד בין ביצועי סט האימון לבין הכללה, בין H100 ל־L40 ובין קבוצות הנתונים, ולזכור שהמאמר הוא דיווח מחברים. הקוד הציבורי Uni-SuperMimic מציג שחזור downstream עם תהליך של GPU יחיד וצ'קפוינט חזק בכ־40 דקות לפי טענת מתחזקי המאגר, אך אין לייחס לו שחזור של תוצאת ה־1,000x או של אפס הכישלונות המקוריים בלי ראיה מפורשת לכך.
המקורות שלנו
המקור, סוג העדות ותאריך הבדיקה זמינים כדי שתוכלו לבדוק בעצמכם.
- SuperMimic — המאמר ב־arXivמקור מחקרי · נבדק 5 בנובמבר 2026
- SuperMimic — דף הפרויקט הרשמימקור רשמי · נבדק 5 בנובמבר 2026
- Uni-SuperMimic — מאגר קוד downstreamמקור מחקרי · נבדק 5 בנובמבר 2026
- Robotics Weekly — גיליון 2026-10-26דיווח עיתונאי · נבדק 5 בנובמבר 2026
מצאתם טעות או מידע שהתעדכן? שלחו תיקון. תיקונים מהותיים יתועדו כאן.